
之前做某公司官網,設計師常會選 Google Fonts 沒有的中文字體。這種字型沒辦法走 Google 的 CDN,只能把整包字型檔放進專案,一套動輒十幾 MB,頁面要等好幾秒才會換成正確的字。另一種情況是客戶不讓網站連 Google Fonts 的 CDN,就算用的是 Noto Sans TC,也得自己託管。
兩種情況的解法一樣:自己把字型拆成小檔,讓瀏覽器只下載這一頁用得到的字。這篇整理我現在用的做法。
中文字型為什麼特別大
英文字型只需要大小寫字母、數字和標點,幾百個字形就夠了,檔案通常只有幾十 KB。
中文不一樣。光是常用的繁體中文就有好幾千字,一套完整的中文字型往往收錄上萬到數萬個字形。以這篇示範用的 Noto Sans TC(思源黑體)Regular 為例:
- 原始 OTF 檔:16.4 MB
- 整包轉成 woff2 壓縮後:11.2 MB
但一個頁面實際用到的字,通常只有幾十到幾百個。這篇示範頁約 130 字,扣掉重複只用到 84 個不同的字,卻要讀者先下載 11 MB 的字型,非常浪費。
解法:拆成子集,交給 unicode-range 決定要載哪些
做法的核心是 CSS @font-face 裡的 unicode-range。它可以宣告「這個字型檔只涵蓋哪些字」:
@font-face { font-family: 'Noto Sans TC'; font-weight: 400; font-display: swap; src: url('./NotoSansTC-Regular.118.woff2') format('woff2'); unicode-range: U+4e3b, U+4f4d, U+4f60, U+524d; /* 實際範圍更長,這裡只列幾個 */ }
我們把一套字型拆成約 100 個 woff2 小檔,每個小檔各寫一段 @font-face,並用 unicode-range 標明它涵蓋的字。瀏覽器渲染頁面時,會比對頁面上出現的每一個字,只下載包含這些字的分塊,其他分塊完全不會請求。
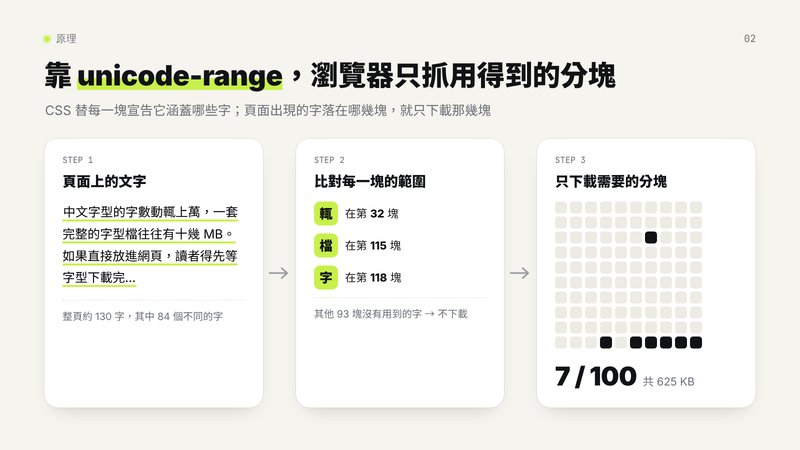
至於「哪些字放同一塊」,我們直接沿用 Google Fonts 對 Noto Sans TC 的切法。Google 分析過大量網頁的用字頻率,把最常用的字集中在少數幾塊。所以一般文章通常只會用到其中 5–10 塊,而且這幾塊在整個網站之間共用,換頁時多半已經在瀏覽器快取裡。
實測結果
用同一個示範頁,分別載入「整包 woff2」和「拆分後的子集」,在 Chromium 把網路限速到 10 Mbps、延遲 150 ms(大約是訊號普通的手機網路)實測:
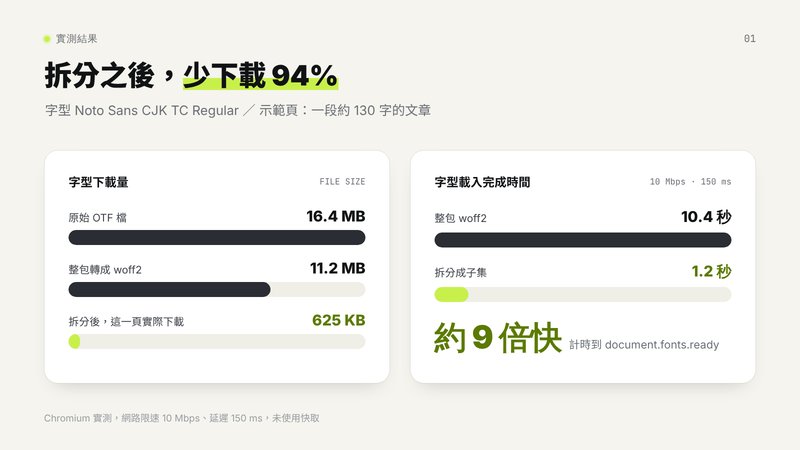
- 整包 woff2:下載 1 個檔案、11.2 MB,字型載入完成 10.4 秒
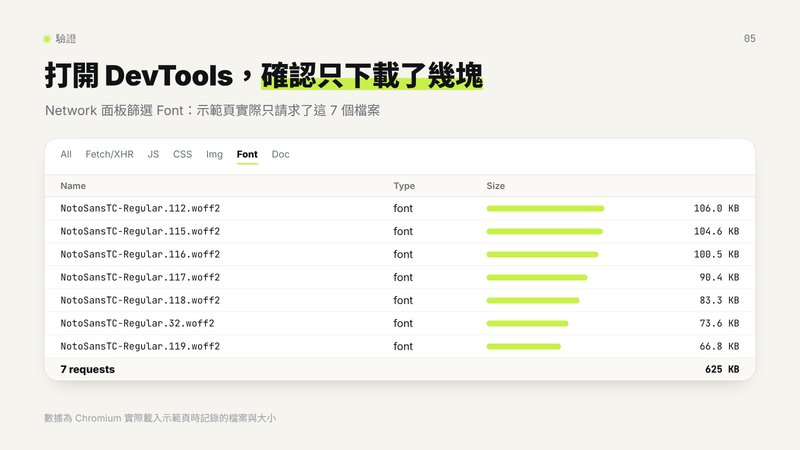
- 拆分成子集:下載 7 個檔案、共 625 KB,字型載入完成 1.2 秒
下載量少了約 94%,字型載入快了將近 9 倍。
動手做
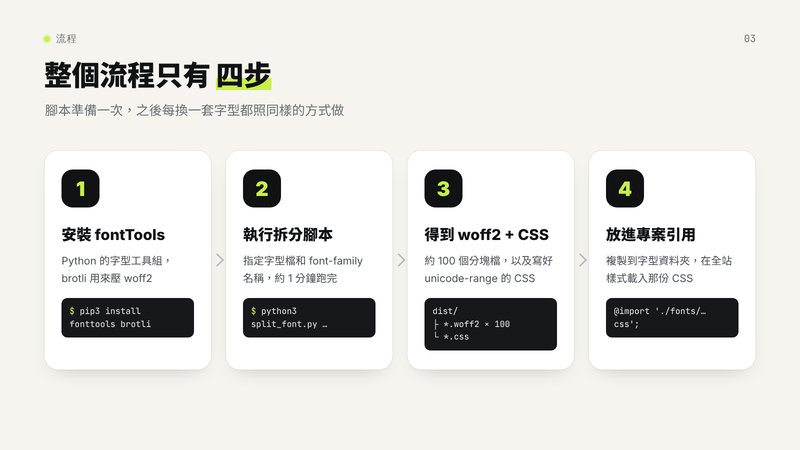
整個流程只有四步:
0. 先確認字型授權
不是每套字型都允許拆分後放到網頁上。動手之前,請先確認授權條款允許「網頁嵌入」和「修改/子集化」。
這篇示範的 Noto Sans TC 採用 SIL Open Font License,可以自由拆分與嵌入;常見的開源中文字型,例如台北黑體、jf open 粉圓,也多半是 OFL 授權。商用字型則請以購買時的授權為準。
1. 安裝 fontTools
需要 Python 3。fonttools 負責拆字型,brotli 用來壓縮成 woff2:
pip3 install fonttools brotli
2. 準備拆分腳本
把下面這支腳本存成 split_font.py,和字型檔放在同一個資料夾:
#!/usr/bin/env python3 """把一套中文字型拆成多個 woff2 子集,並產生對應的 @font-face CSS。 用法: python3 split_font.py 字型檔.ttf --family "My Sans" --weight 400 需要:pip3 install fonttools brotli """ import argparse import json import re import urllib.request from concurrent.futures import ProcessPoolExecutor from pathlib import Path from fontTools import subset from fontTools.ttLib import TTFont # 向 Google Fonts 借用它對繁體中文的分塊方式(約 100 塊,常用字集中在前幾塊) GOOGLE_CSS = "https://fonts.googleapis.com/css2?family=Noto+Sans+TC&display=swap" # 要帶瀏覽器的 User-Agent,Google 才會回傳 woff2 + unicode-range 的版本 UA = "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/126.0 Safari/537.36" def fetch_ranges(): req = urllib.request.Request(GOOGLE_CSS, headers={"User-Agent": UA}) css = urllib.request.urlopen(req, timeout=30).read().decode("utf-8") return parse_ranges(css) def parse_ranges(css): """從 Google Fonts 的 CSS 取出每一塊的編號與 unicode-range。""" blocks = re.findall(r"/\*\s*\[(\d+)\]\s*\*/\s*@font-face\s*\{(.*?)\}", css, re.S) ranges = [] for num, body in blocks: m = re.search(r"unicode-range:\s*([^;]+);", body) if m: ranges.append({"slice": int(num), "range": m.group(1).strip()}) return ranges def make_one(job): font_path, out_path, unicode_range = job options = subset.Options() options.flavor = "woff2" options.layout_features = ["*"] # 保留直排、標點擠壓等排版功能 options.name_IDs = ["*"] options.notdef_outline = True font = TTFont(font_path) subsetter = subset.Subsetter(options) subsetter.populate(unicodes=subset.parse_unicodes(unicode_range.replace(" ", ""))) subsetter.subset(font) if not font.getBestCmap(): # 這套字型在這一塊沒有任何字,就不輸出 return None font.flavor = "woff2" font.save(out_path) return out_path def main(): ap = argparse.ArgumentParser() ap.add_argument("font", help="原始字型檔(.ttf 或 .otf)") ap.add_argument("--family", required=True, help="CSS 裡要用的 font-family 名稱") ap.add_argument("--weight", default="400", help="字重,例如 400、700") ap.add_argument("--out", default="dist", help="輸出資料夾") ap.add_argument("--ranges", help="分塊範圍 JSON;不指定就即時向 Google Fonts 取得") args = ap.parse_args() ranges = json.load(open(args.ranges, encoding="utf-8")) if args.ranges else fetch_ranges() out = Path(args.out) out.mkdir(parents=True, exist_ok=True) stem = Path(args.font).stem jobs = [(args.font, str(out / f"{stem}.{r['slice']}.woff2"), r["range"]) for r in ranges] with ProcessPoolExecutor() as pool: # 用多核心同時拆,速度快好幾倍 results = list(pool.map(make_one, jobs)) css = [] for r, path in zip(ranges, results): if not path: continue css.append( "@font-face {\n" f" font-family: '{args.family}';\n" " font-style: normal;\n" f" font-weight: {args.weight};\n" " font-display: swap;\n" f" src: url('./{Path(path).name}') format('woff2');\n" f" unicode-range: {r['range']};\n" "}\n" ) css_path = out / f"{stem}.css" css_path.write_text("\n".join(css), encoding="utf-8") print(f"完成:{sum(1 for p in results if p)} 個 woff2,CSS 在 {css_path}") if __name__ == "__main__": main()
3. 執行
在終端機切到字型所在的資料夾,指定字型檔、CSS 要用的 font-family 名稱和字重:
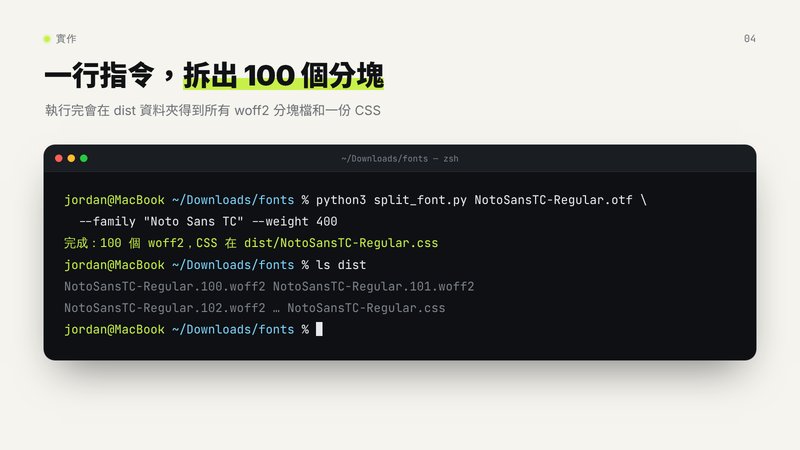
cd ~/Downloads/fonts python3 split_font.py NotoSansTC-Regular.otf --family "Noto Sans TC" --weight 400
在一般的筆電上大約一分鐘就跑完,所有檔案都會放在 dist 資料夾:
同一套字型有多個字重時,對每個字重的檔案各跑一次,--family 用同一個名稱、--weight 填對應的數字即可。例如粗體:
python3 split_font.py NotoSansTC-Bold.otf --family "Noto Sans TC" --weight 700
4. 放進專案
把 dist 裡的所有 woff2 和 CSS 一起複製到專案的公開資料夾,例如 public/fonts/。CSS 裡的路徑是相對路徑,所以兩者要放在同一層。
一般 HTML:在 <head> 載入 CSS:
<link rel="stylesheet" href="/fonts/NotoSansTC-Regular.css">
Nuxt 3:放在 public/fonts/,再到 nuxt.config.ts 加入:
export default defineNuxtConfig({ app: { head: { link: [{ rel: 'stylesheet', href: '/fonts/NotoSansTC-Regular.css' }], }, }, })
Tailwind CSS v4:在主要的 CSS 檔把字型設成預設字體:
@theme { --font-sans: "Noto Sans TC", ui-sans-serif, system-ui, sans-serif; }
最後在樣式裡使用。記得在後面接上系統字型當備援:
body { font-family: 'Noto Sans TC', 'PingFang TC', 'Microsoft JhengHei', sans-serif; }
驗證:確認真的只下載了幾塊
打開瀏覽器的 DevTools,切到 Network 面板,篩選 Font,重新整理頁面。應該只會看到少數幾個 woff2 被下載,而不是全部 100 個:
如果發現 100 個檔案全部都被下載了,通常是以下兩個原因之一:
- CSS 裡的
unicode-range不見了或寫錯,瀏覽器不知道每一塊涵蓋哪些字,只好全部下載 - 對字型檔用了
<link rel="preload">。preload 會強制下載,就失去拆分的意義了
常見問題
有些罕用字沒有套用到字型?
Google 的分塊涵蓋了約一萬五千個常用與次常用字。少數更罕見的字不在任何一塊裡,會改用 font-family 後面的系統字型顯示。一般網站很少遇到;如果你的內容大量使用罕用字,例如古籍或人名資料庫,可以考慮另外補一塊。
分塊範圍抓不到怎麼辦?
腳本預設會連線到 Google Fonts。如果公司網路擋住了,或你想固定使用同一份範圍,可以先在能連線的環境把範圍存成 JSON,之後用 --ranges ranges.json 指定這個檔案,就不必每次連線。
更新網站時要注意快取嗎?
字型檔幾乎不會變動,建議在伺服器設定長時間快取。以 Nginx 為例:
location /fonts/ { expires 1y; add_header Cache-Control "public, immutable"; }
要注意的是,在 location 裡寫 add_header,會讓這個 location 不再繼承 server 層級設定的其他標頭,例如 HSTS、CSP。如果你在 server 層級有設定安全標頭,記得在這裡一併補上。
結語
如果你的專案已經在用中文網頁字型,可以先打開 DevTools 的 Network 面板,看看目前下載了多大的字型檔,也許可以試試看拆分